크롤링이랑 색인은 다릅니다 — 색인 상태 용어 완전 정리
안녕하세요, 천상나타입니다.
블로그나 사이트를 운영하다 보면 "글을 올렸는데 검색에 안 떠요"라는 상황을 한 번쯤 겪습니다. 저도 제 사이트 1,218개 페이지를 서치콘솔 API로 전수 검사해봤는데, 색인된 게 45%뿐이었어요. 그런데 조사하면서 알게 된 게 하나 있습니다 — 대부분의 "색인 안 됨"은 사실 종류가 다 다르더라고요.
오늘은 그 용어들을 정리해봅니다. 서치콘솔에서 뜨는 상태 메시지가 뭘 의미하는지, 어느 단계에서 막힌 건지 이해하면 대응이 훨씬 쉬워집니다.
먼저, URL이 검색 결과에 뜨기까지
URL은 이런 파이프라인을 지나갑니다.
- 발견(Discovered) — 구글이 그 URL의 존재를 "알게 된" 상태예요. 사이트맵에 넣었거나, 어딘가 링크를 타고 찾아낸 거죠. 아직 방문은 안 했습니다.
- 크롤링(Crawled) — 구글봇이 실제로 방문해서 HTML을 가져간 상태예요.
- 평가(Evaluated) — 가져온 내용을 보고 "색인할 가치가 있는가"를 판단해요. 콘텐츠가 얇거나, 다른 페이지와 겹치거나, canonical이 꼬여 있으면 여기서 탈락합니다.
- 색인(Indexed) — 구글 검색 DB에 저장된 상태. 그런데 주의할 게 있어요.
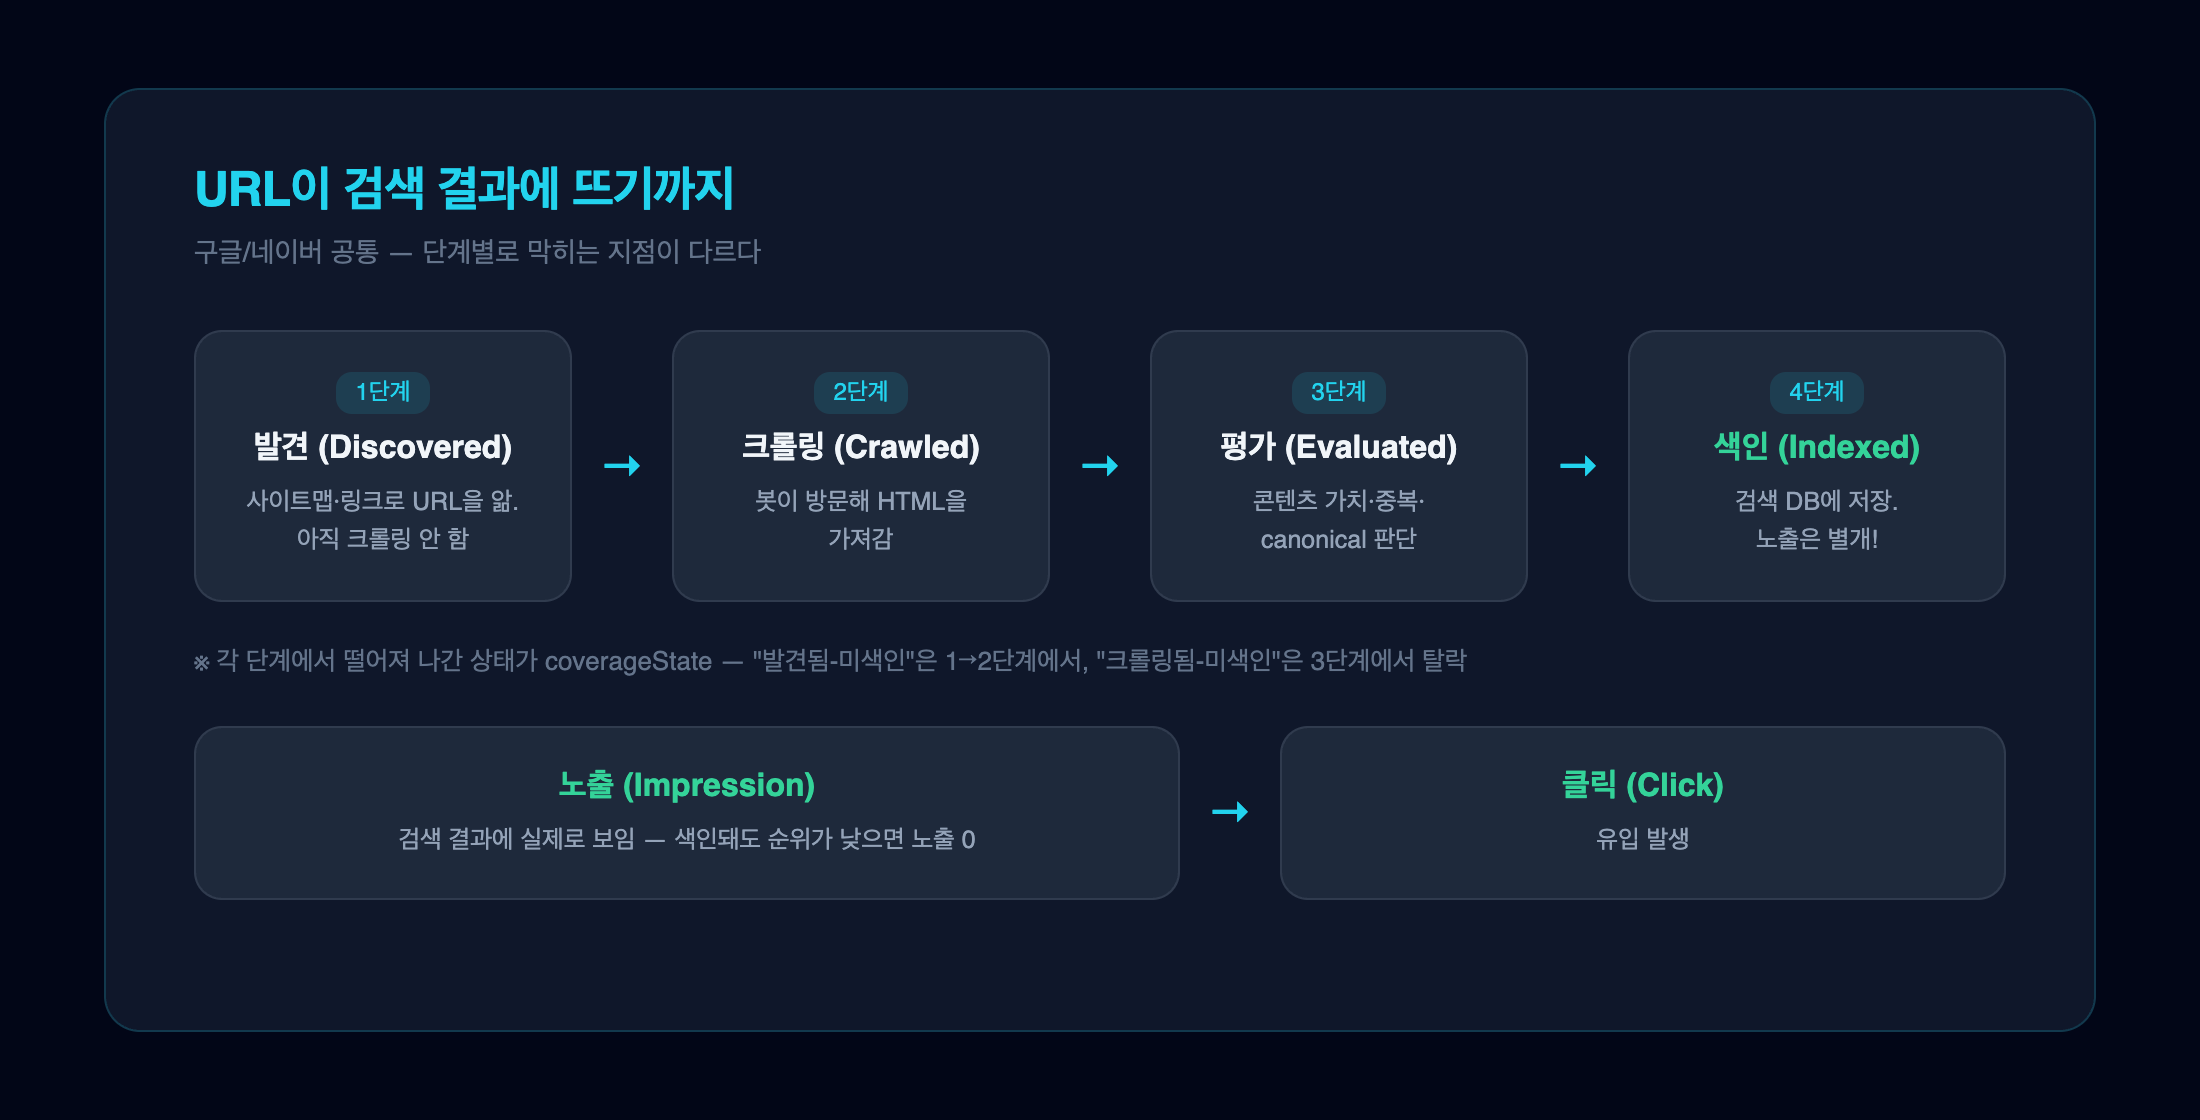
색인됐다고 끝이 아닙니다. 색인은 "창고에 보관"이고, 검색 결과에 실제로 뜨는 건 "노출(Impression)"이라는 또 다른 단계예요. 색인돼도 순위가 낮으면 노출은 0입니다. 이 구분이 뒤에 네이버 이야기에서 중요해져요.
상태별로 정리하면
실제 검사 화면입니다. 미색인이면 이렇게 어떤 단계에서 멈췄는지가 뜹니다.
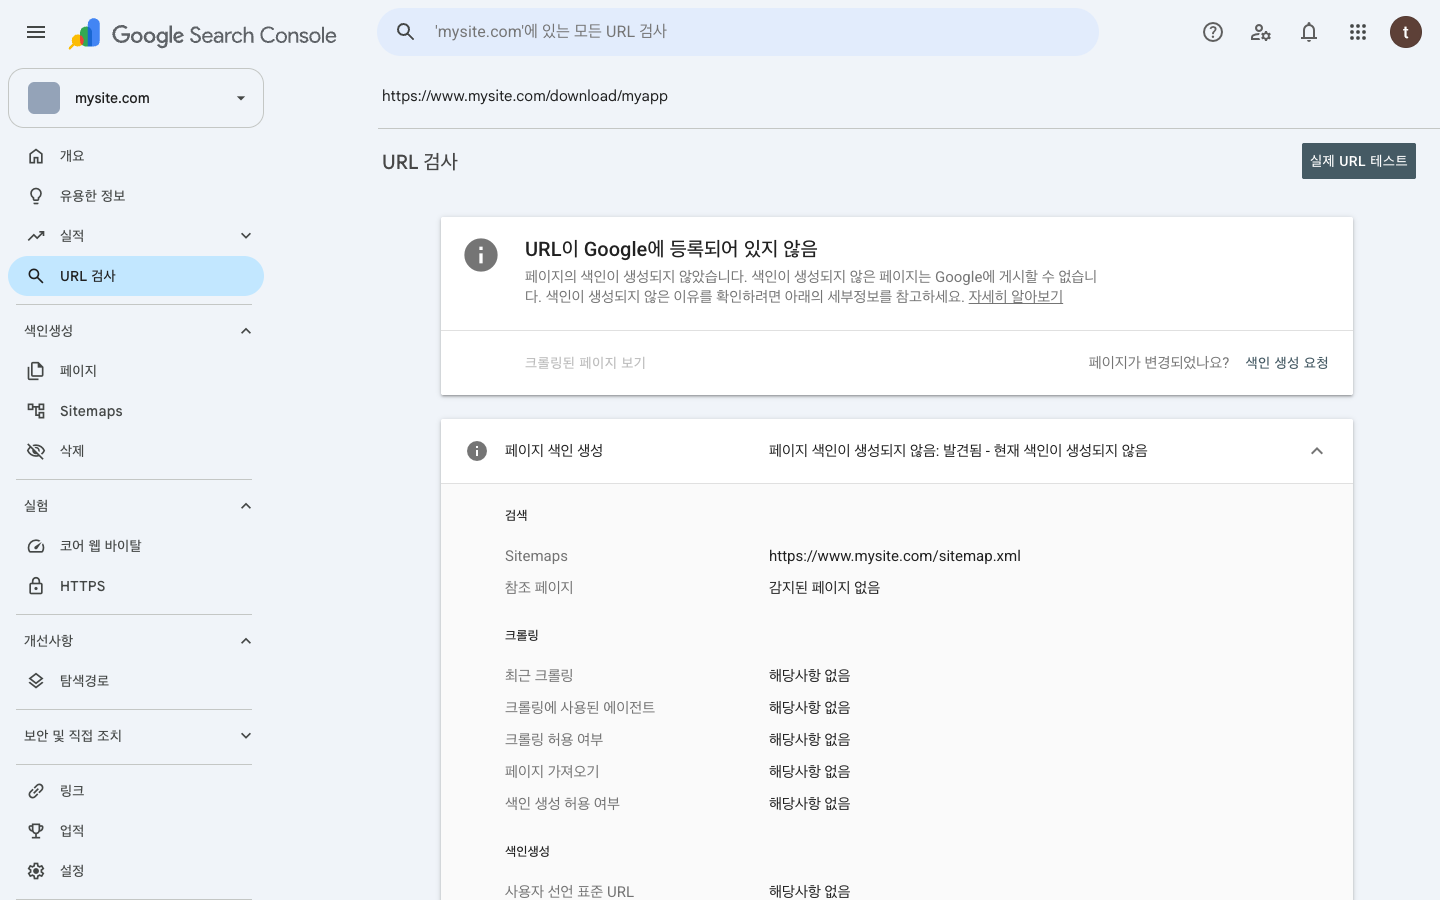
화면에 보이는 상태 문구들을 정리하면 이렇게 됩니다.
| 상태 메시지 | 의미 | 어디서 막힘 |
|---|---|---|
| Google에 알려지지 않은 URL | 사이트맵·링크로도 못 찾은 주소 | 발견 전 |
| 발견됨 - 현재 색인이 생성되지 않음 | URL은 아는데 크롤링을 아직 안 함 (또는 미룸) | 발견 → 크롤링 사이 |
| 크롤링됨 - 현재 색인이 생성되지 않음 | 가져가긴 했는데 색인할 가치 없다고 판단 | 평가 단계 |
| 중복 페이지, 표준이 설정되지 않음 | 비슷한 페이지가 여러 개인데 표준 주소를 안 알려줌 | 평가 단계 (canonical) |
| 중복 페이지, Google에서 사용자와 다른 표준을 선택함 | 내가 정한 표준 주소를 구글이 무시함 | 평가 단계 (canonical 꼬임) |
| noindex 태그에 의해 제외됨 | 페이지 스스로 "색인하지 마세요" 선언 | 의도된 제외 |
| 404 / 리디렉션 | 페이지 없음 또는 다른 주소로 보냄 | 구조 문제 |
여기서 제일 헷갈리는 게 "발견됨"과 "크롤링됨"의 차이예요. 둘 다 미색인인데 성격이 다릅니다.
- "발견됨-미색인"은 구글이 일부러 크롤링을 미루는 경우가 많아요. 크롤링 예산(crawl budget)이 아깝거나, "이 사이트 새 페이지 품질이 애매한데?" 하고 관망하는 상태죠. 사이트의 평판이나 신선도가 쌓이면 풀립니다.
- "크롤링됨-미색인"은 방문까지 했는데 콘텐츠를 보고 버렸다는 뜻이라 더 심각해요. 얇은 콘텐츠, 중복, 광고 위주 페이지 같은 게 여기 해당합니다.
실제 데이터로 보면
제 사이트 1,218개 URL을 API로 검사한 분포입니다.
- 색인됨: 543개 (45%)
- 발견됨-미색인: 436개 (36%) — 가장 큰 비중
- Google에 알려지지 않은 URL: 225개 (18%)
- 크롤링됨-미색인: 13개
- 그 외 canonical 문제 등
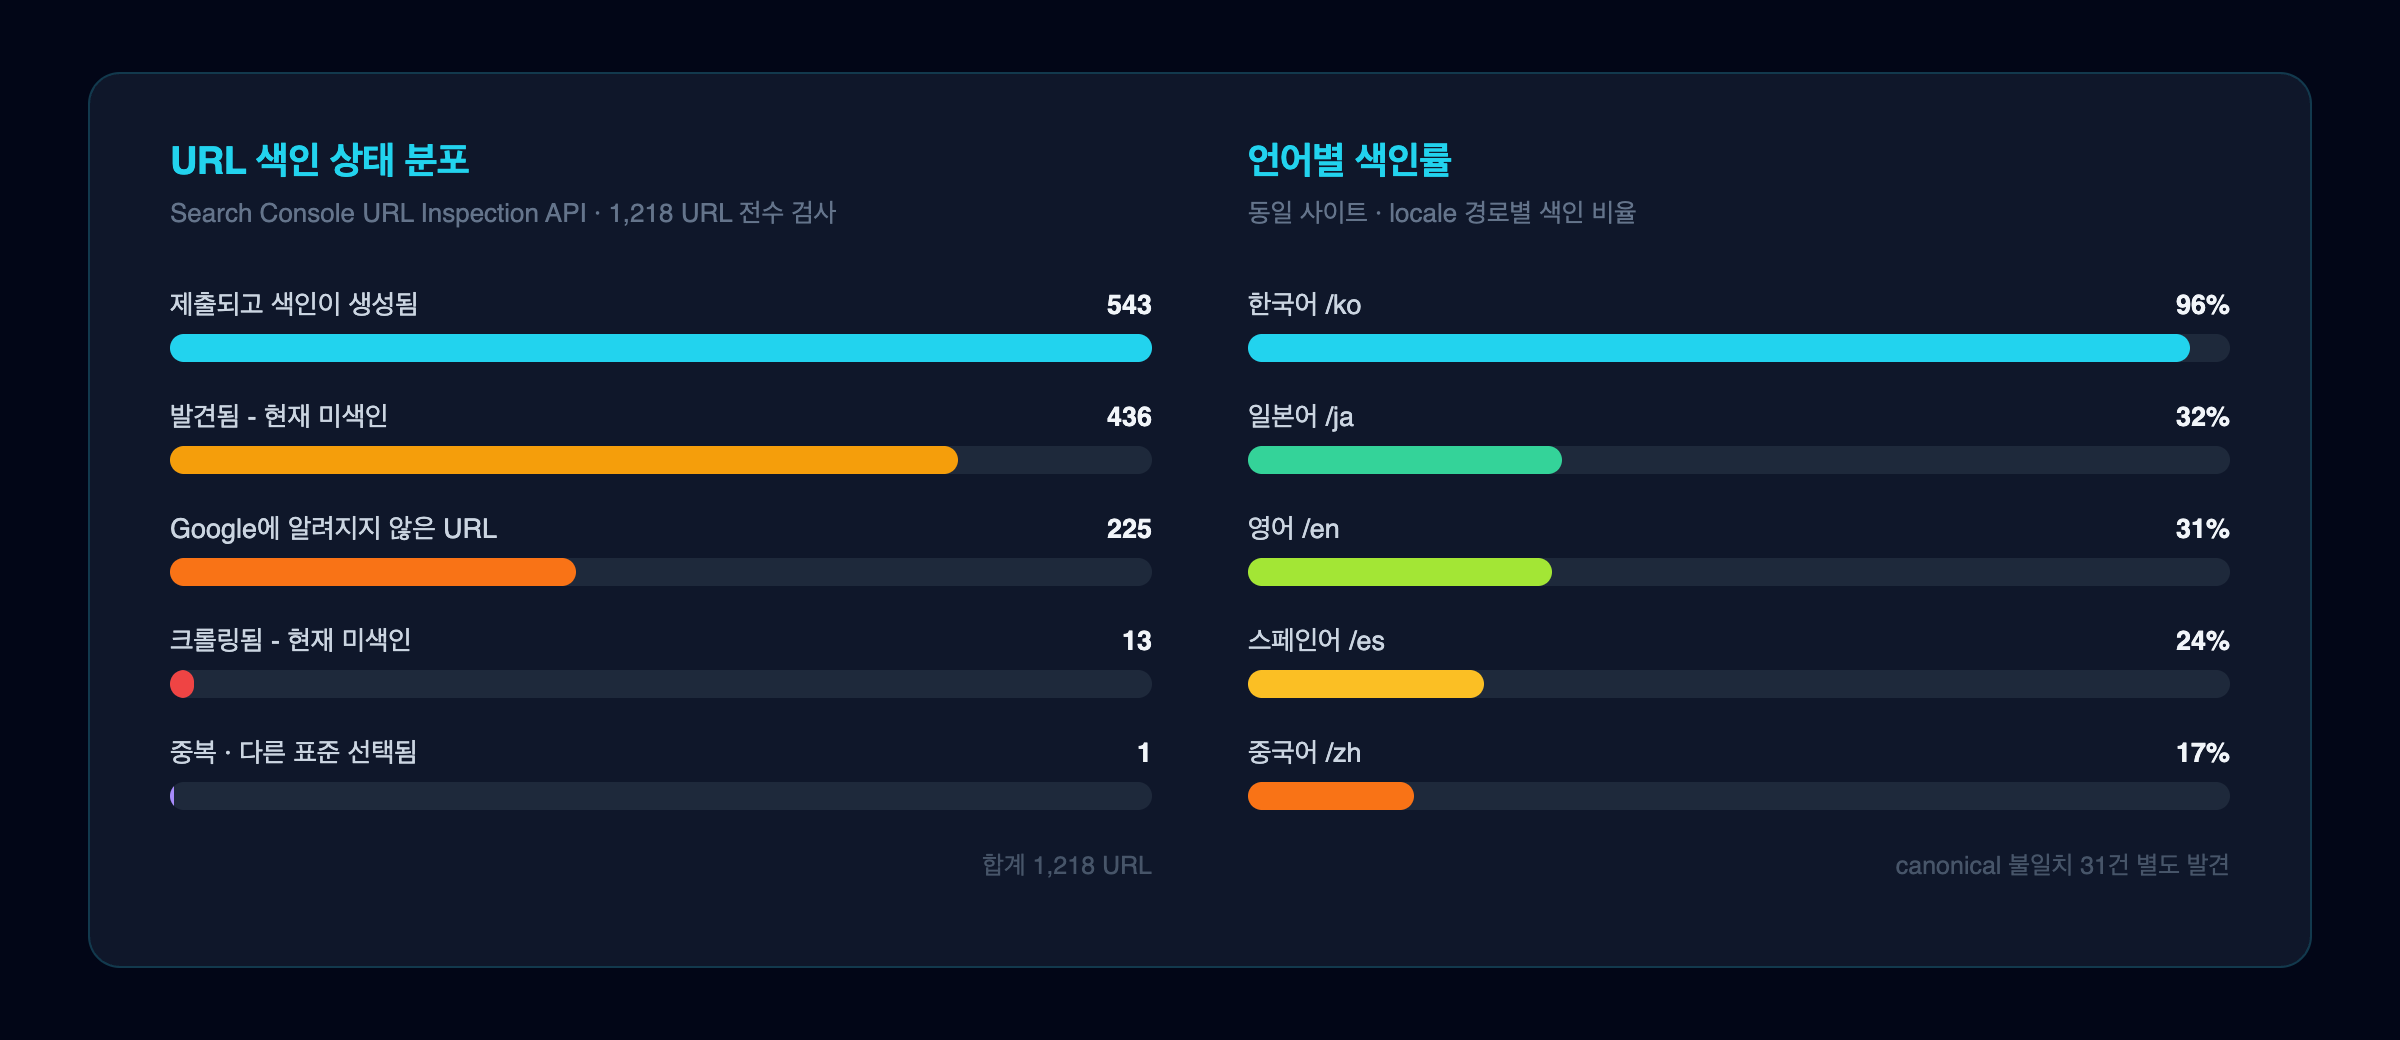
재밌는 건 언어별 편차예요. 한국어 페이지는 96%가 색인됐는데, 영어·일본어 등 다국어 페이지는 17~32% 수준이었어요. 원인은 다음 글에서 다룰 canonical 버그였는데, 이것도 "크롤링이 안 됐다"가 아니라 "평가에서 튕겼다"라는 종류의 문제였습니다.
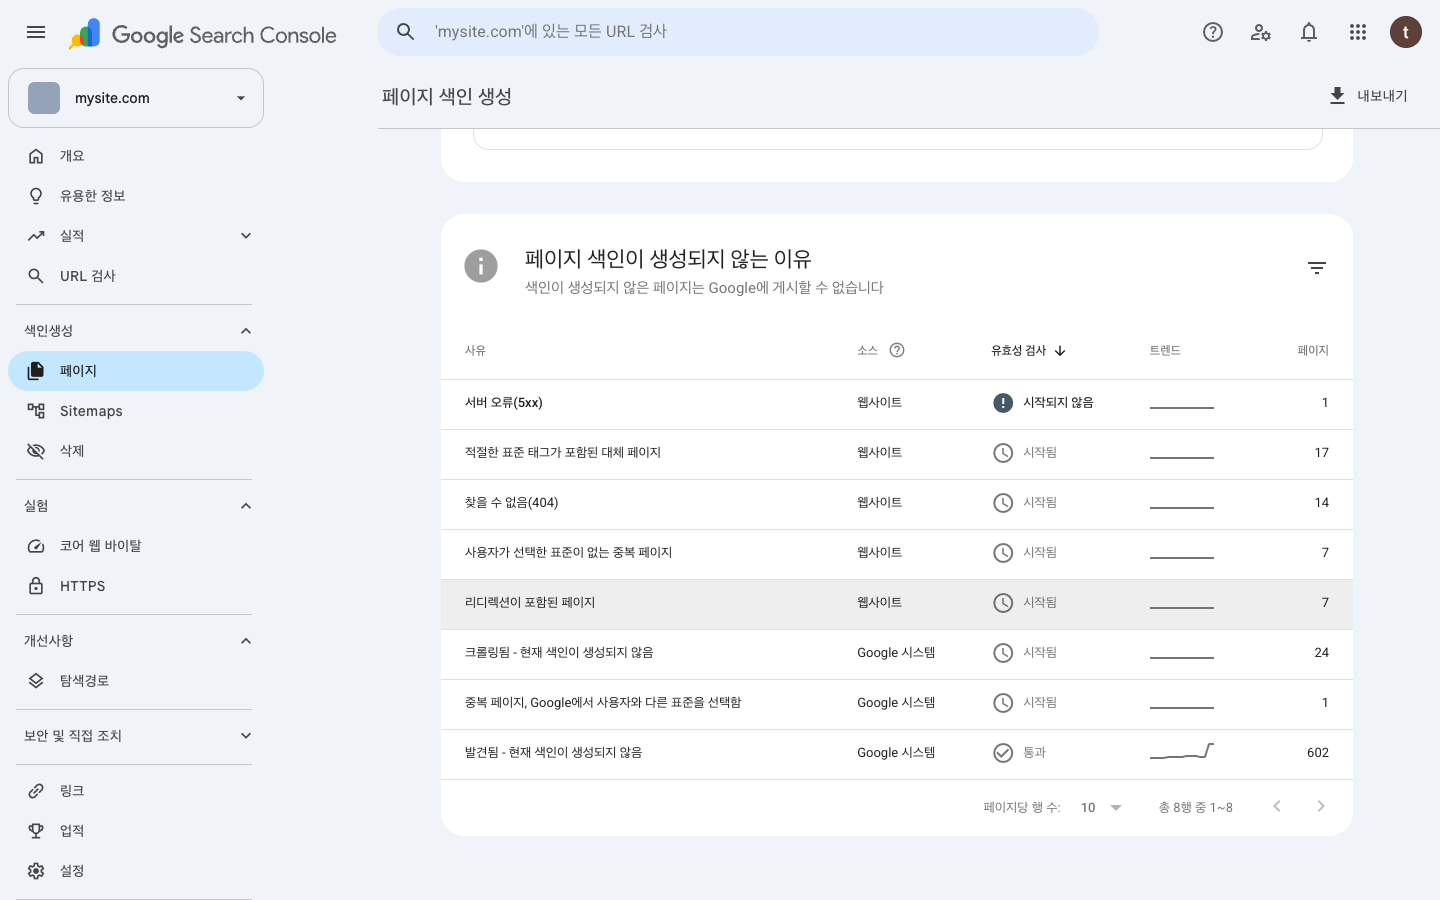
서치콘솔의 색인 생성 리포트에서도 이유별로 묶여서 보여줍니다.
그래서 뭘 해야 하나?
상태별로 처방이 다릅니다.
- 알려지지 않은 URL → sitemap에 넣고, 글 안에서 링크 걸어주기. 발견 자체가 안 된 거라 등록이 먼저예요.
- 발견됨-미색인 → 기다리는 게 기본이지만, 중요한 페이지는 색인 생성 요청. 사이트 전체의 콘텐츠 품질을 올리면 같이 풀려요.
- 크롤링됨-미색인 → 콘텐츠 자체를 손봐야 합니다. 얇은 페이지는 합치거나 보강.
- canonical 문제 → 다음 글에서 자세히 다룰 주제예요. 페이지가 "표준 주소"를 엉뚱하게 선언하고 있으면 구글이 색인을 꼬이게 합니다.
정리
- 색인 안 됨 ≠ 한 가지 문제. 발견/크롤링/평가 중 어디서 막혔는지를 먼저 봐야 해요
- "발견됨-미색인"은 관망, "크롤링됨-미색인"은 탈락 — 후자가 더 심각
- 색인은 저장이고 노출은 별개의 문제라는 것도 기억해두세요
- 페이지가 적으면 서치콘솔 URL 검사로 충분하고, 수백 개 이상이면 지난 글의 API 방식이 답입니다
다음 글에서는 이 작업을 돌린 자동화 도구인 Playwright 브라우저 자동화를 개념부터 정리해볼게요.
