구글 서치콘솔, URL 하나씩 검사하고 계셨나요? API로 1,200개 한 번에 점검한 후기
안녕하세요, 천상나타입니다.
최근에 제 사이트 페이지가 구글 검색에 제대로 안 뜨는 문제를 파고들다가, 서치콘솔에 생각보다 잘 알려지지 않은 기능이 있다는 걸 알게 됐어요. 바로 URL 검사 API입니다. 웹 화면에서 하나씩 눌러보던 그 검사를, 코드로 수백 수천 개 한 번에 돌릴 수 있는 기능이에요. 준비부터 실제 결과까지 캡처 그대로 정리해봤습니다.
보통 우리가 아는 방법
페이지가 검색에 안 뜨면 서치콘솔 상단의 검사창에 URL을 넣어보잖아요.
이렇게 넣으면 "Google에 등록되어 있음 / 있지 않음"과 그 이유를 보여줍니다.
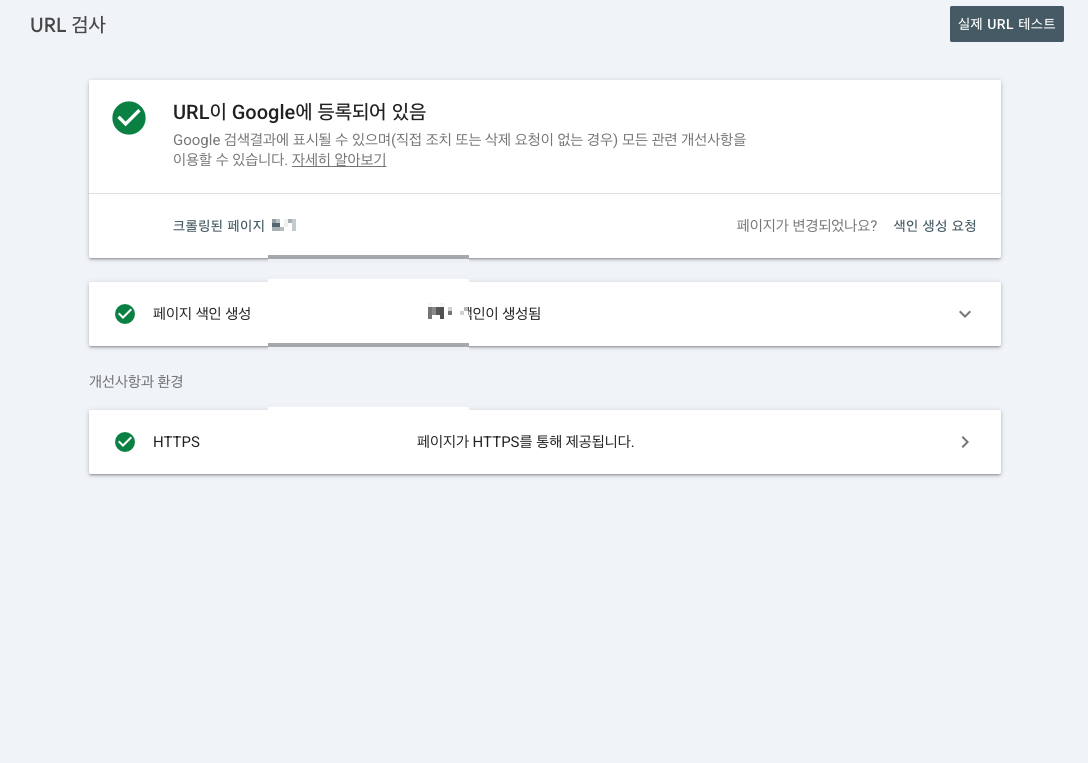
문제는 이게 한 번에 하나씩만 된다는 거예요. 페이지가 수십 개면 모르겠는데 제 사이트처럼 1,200개가 넘어가면 물리적으로 불가능합니다. 수동 검사에도 할당량이 있어서 연타로 누르는 것도 금방 막히고요.
그런데 API가 있었습니다
서치콘솔에는 URL Inspection API가 있어서 이 검사 기능을 그대로 프로그램으로 호출할 수 있습니다. 웹 화면에서 보는 것과 동일한 데이터를 JSON으로 받습니다.
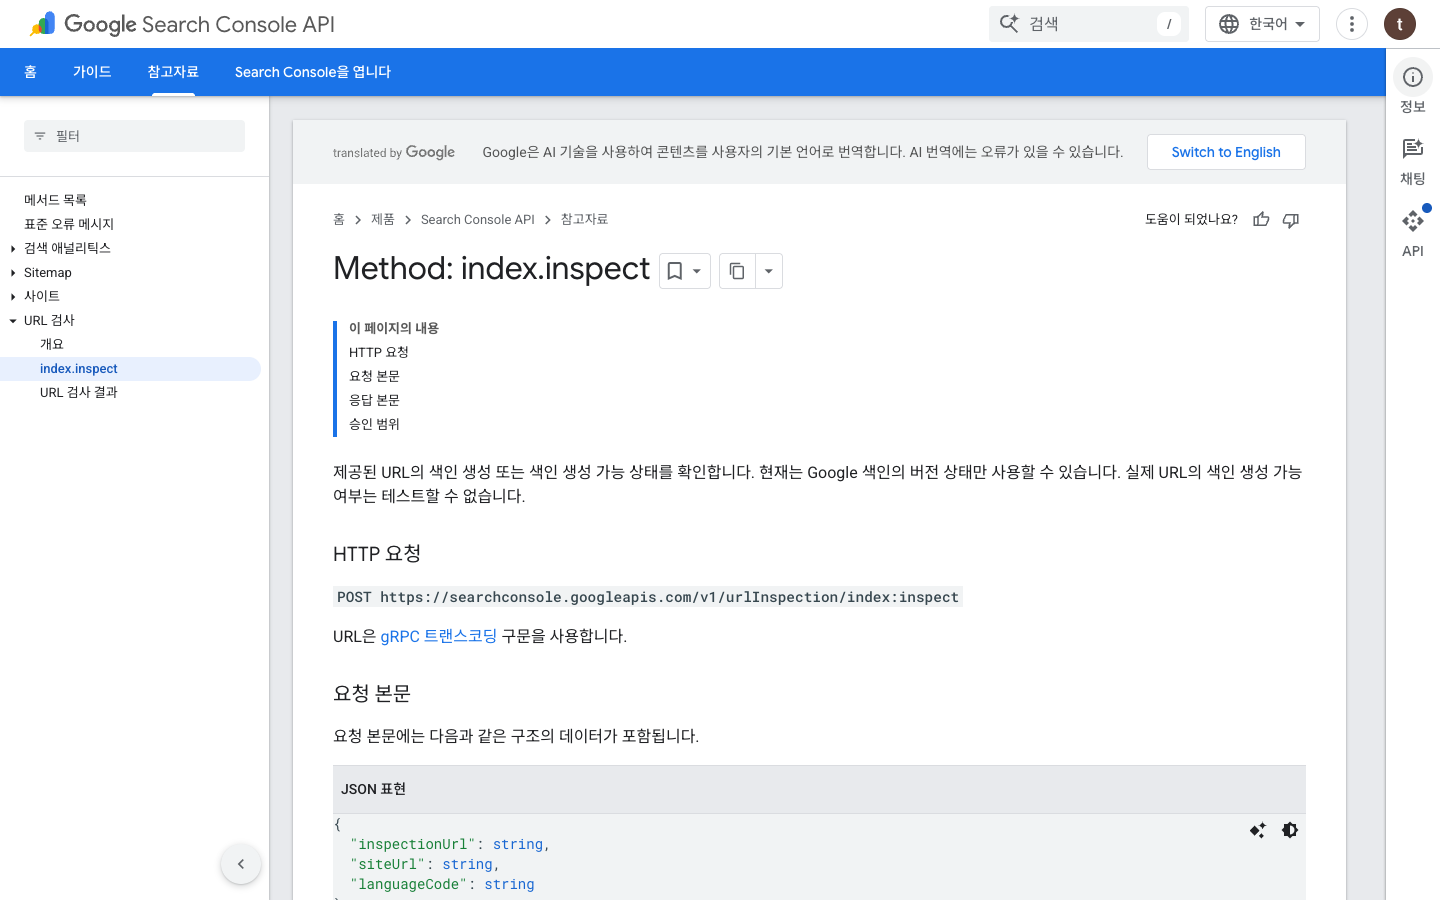
공식 문서 기준 할당량은 속성당 하루 약 2,000건, 분당 600건입니다. 제 사이트 규모면 하루에 전수 조사가 끝나는 수준이에요.
준비 과정 (캡처 그대로)
준비는 생각보다 간단합니다. 10분이면 끝나요.
- Google Cloud 콘솔에서 프로젝트를 만들고 Search Console API를 사용 설정합니다.
- 서비스 계정을 만들고 JSON 키 파일을 내려받습니다. 이 키가 사실상 비밀번호라서 외부에 올리면 절대 안 됩니다.
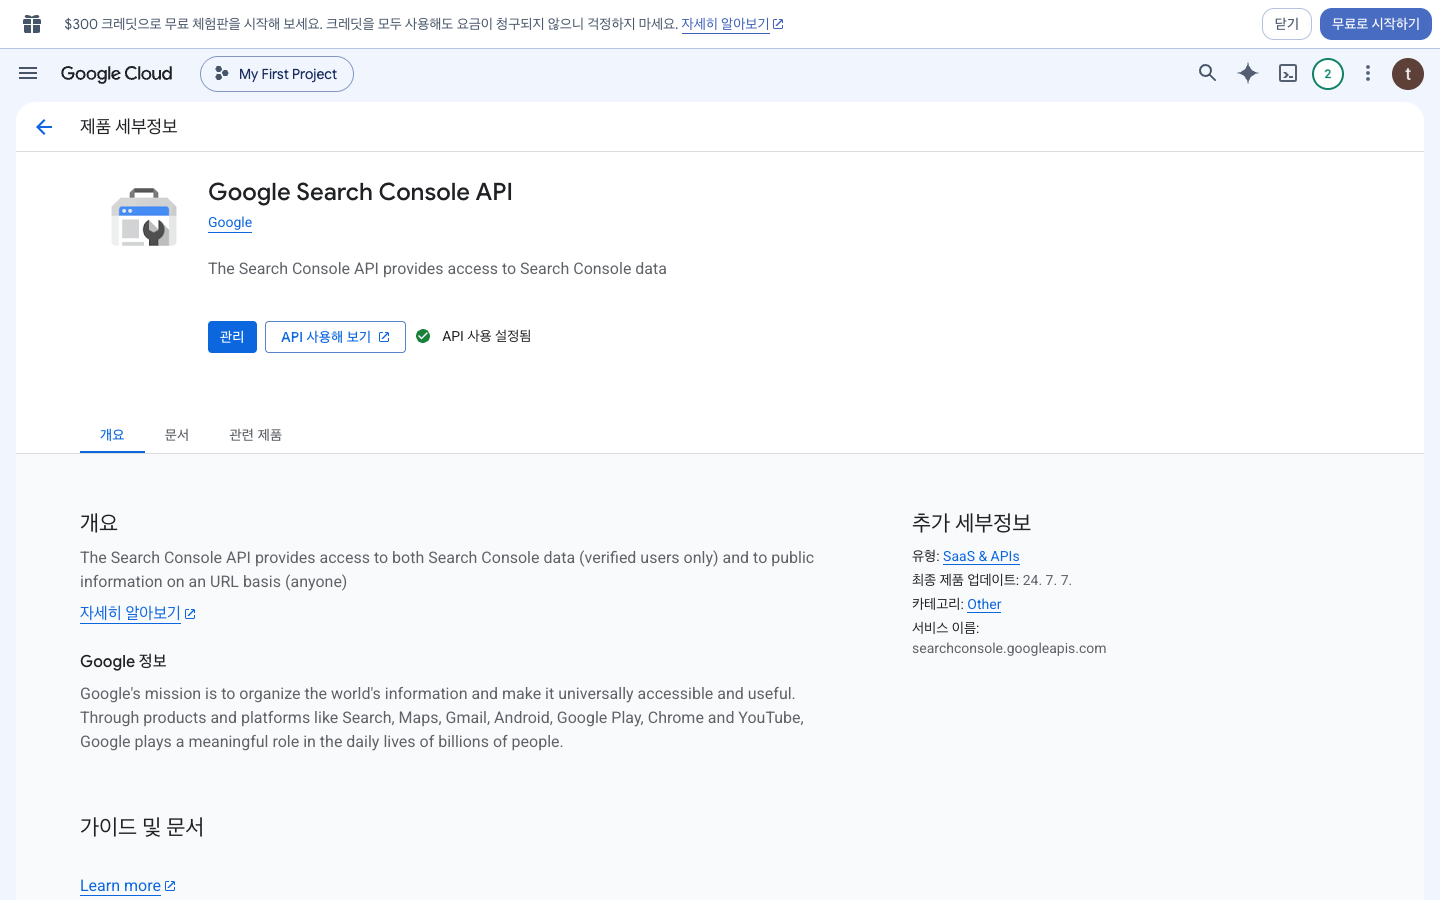
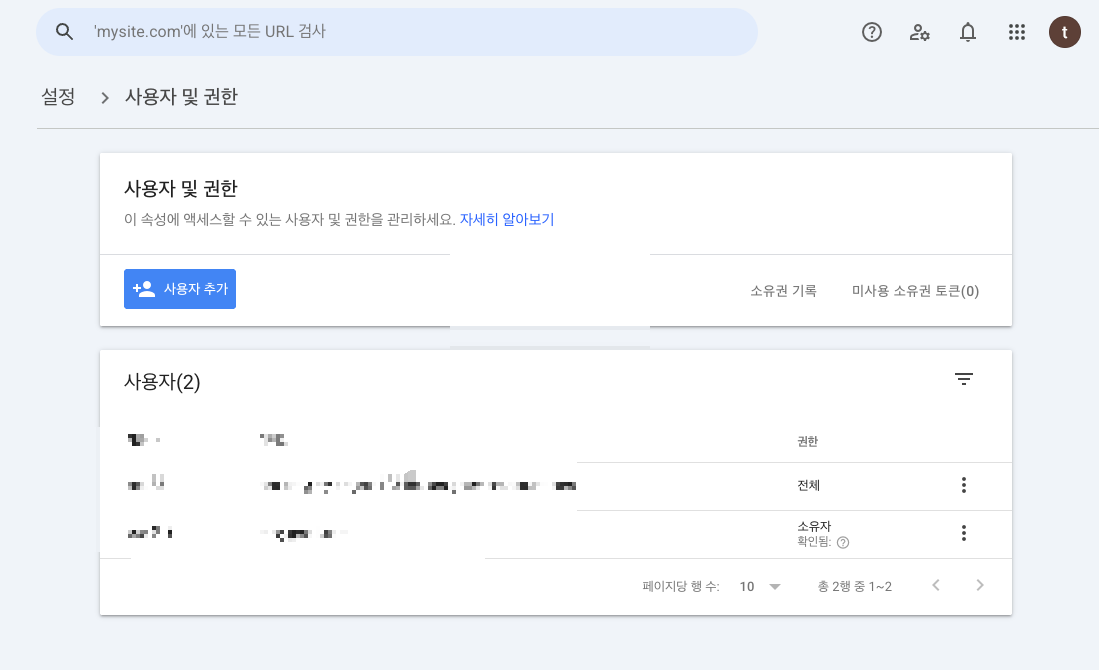
- 마지막으로 서치콘솔 설정 > 사용자 및 권한에서 그 서비스 계정 이메일을 사용자로 추가합니다. 읽기만 할 거면 '제한됨' 권한으로도 충분합니다.
API가 실제로 주는 데이터
호출하면 웹 화면과 동일한 정보가 JSON으로 내려옵니다. 핵심 필드는 이겁니다.
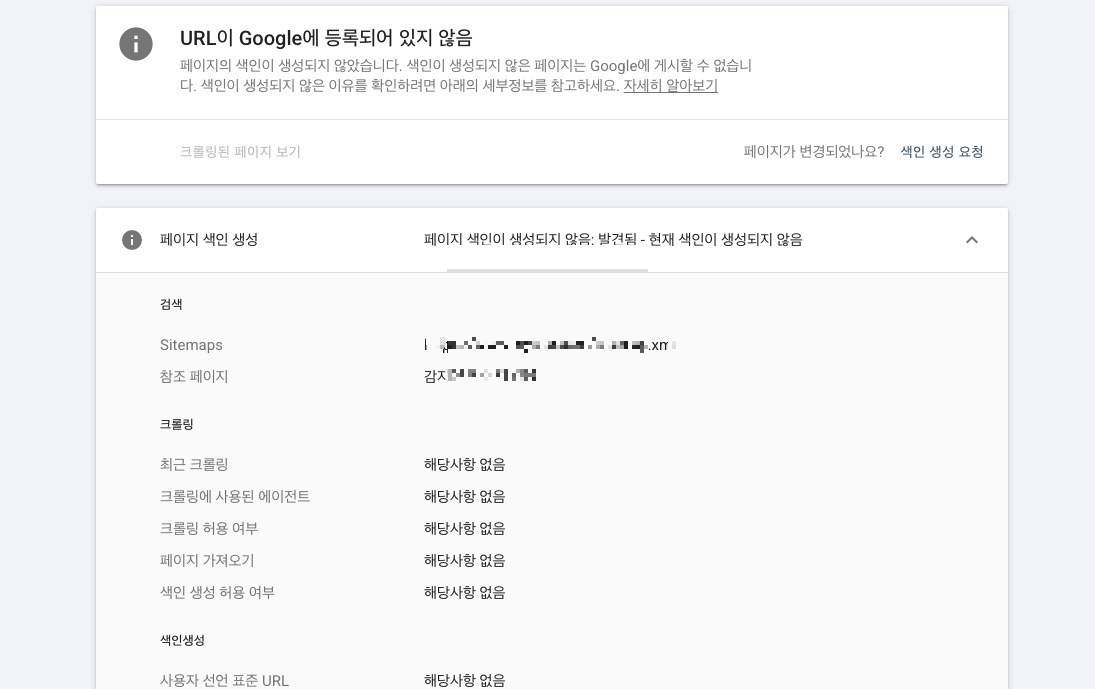
coverageState— 색인 상태. "제출되고 색인이 생성됨", "발견됨 - 현재 색인이 생성되지 않음", "크롤링됨 - 현재 색인이 생성되지 않음" 같은 값이 옵니다userCanonical/googleCanonical— 내가 선언한 표준 주소 vs 구글이 고른 표준 주소. 이 둘이 다르면 의심해야 합니다lastCrawlTime,crawledAs,referringUrls— 마지막 크롤링 시각, 어떤 봇이 왔는지, 어디서 링크를 탔는지pageFetchState— 페이지를 정상적으로 가져갔는지- 모바일 사용성, 리치 결과 오류까지 같이 옵니다
미색인 페이지를 검사하면 웹에서 아래 화면이 보이는 것과 같은 정보를 받는다고 보시면 됩니다.
실제로 1,218개 전수 검사해봤습니다
사이트맵에 있는 URL 1,218개를 전부 돌렸습니다. 스크립트는 sitemap.xml을 읽어서 순차 호출하고 결과를 JSON에 누적 저장하도록 만들었어요. 중간에 끊겨도 이어서 돌아갑니다.
결과가 바로 나왔는데, 웹 리포트랑 같은 그림입니다.
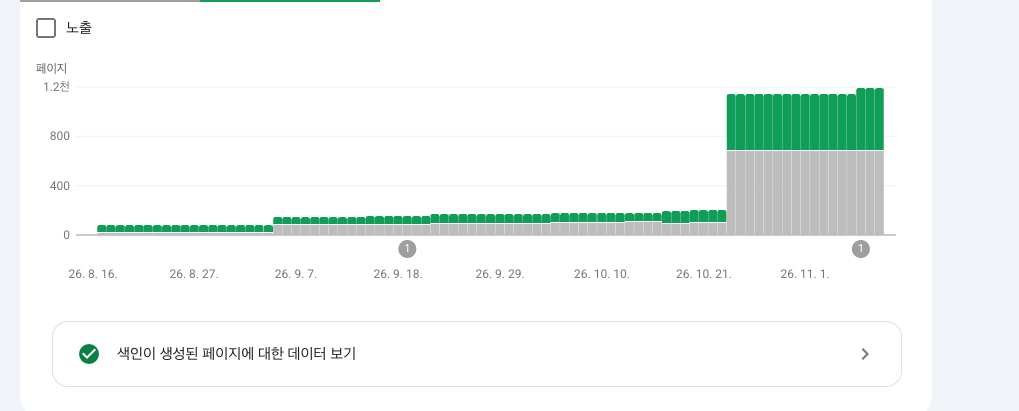
색인 515개, 미색인 673개. 미색인 이유를 열어보면 이렇습니다.
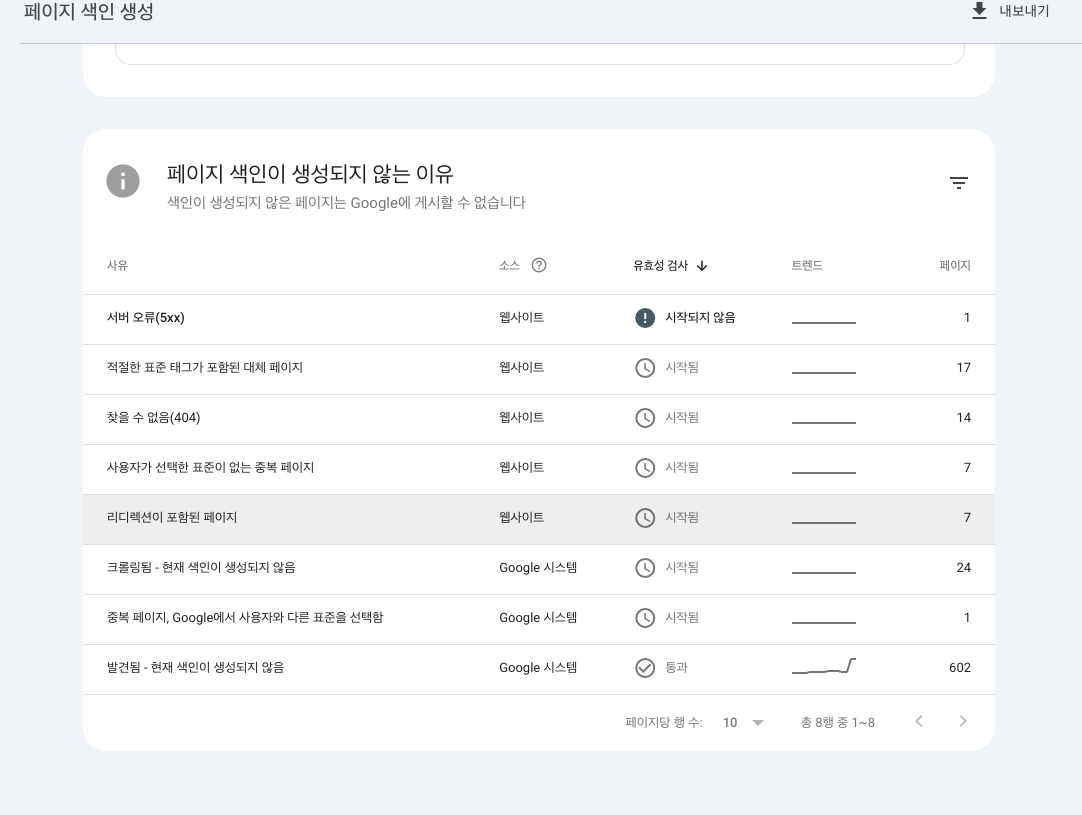
"발견됨 - 현재 색인이 생성되지 않음"이 602개로 압도적이었어요. 구글이 URL은 알고 있는데 아직 크롤링조차 안 온 상태입니다. 크롤링된 건 24개뿐이었고요.
API로 돌리니까 새로 보인 것
여기까진 웹 리포트로도 볼 수 있는데, API의 진짜 가치는 URL별로 canonical을 뽑아서 나란히 비교할 수 있다는 데 있었습니다.
제 사이트는 다국어라 /ko, /en, /ja, /zh, /es로 나뉘는데, 한국어는 96%가 색인된 반면 영어·일본어·중국어·스페인어는 17~32%만 색인돼 있었어요. 사이트 자체에 문제가 있는 게 아니라 다국어 쪽만 문제인 거죠.
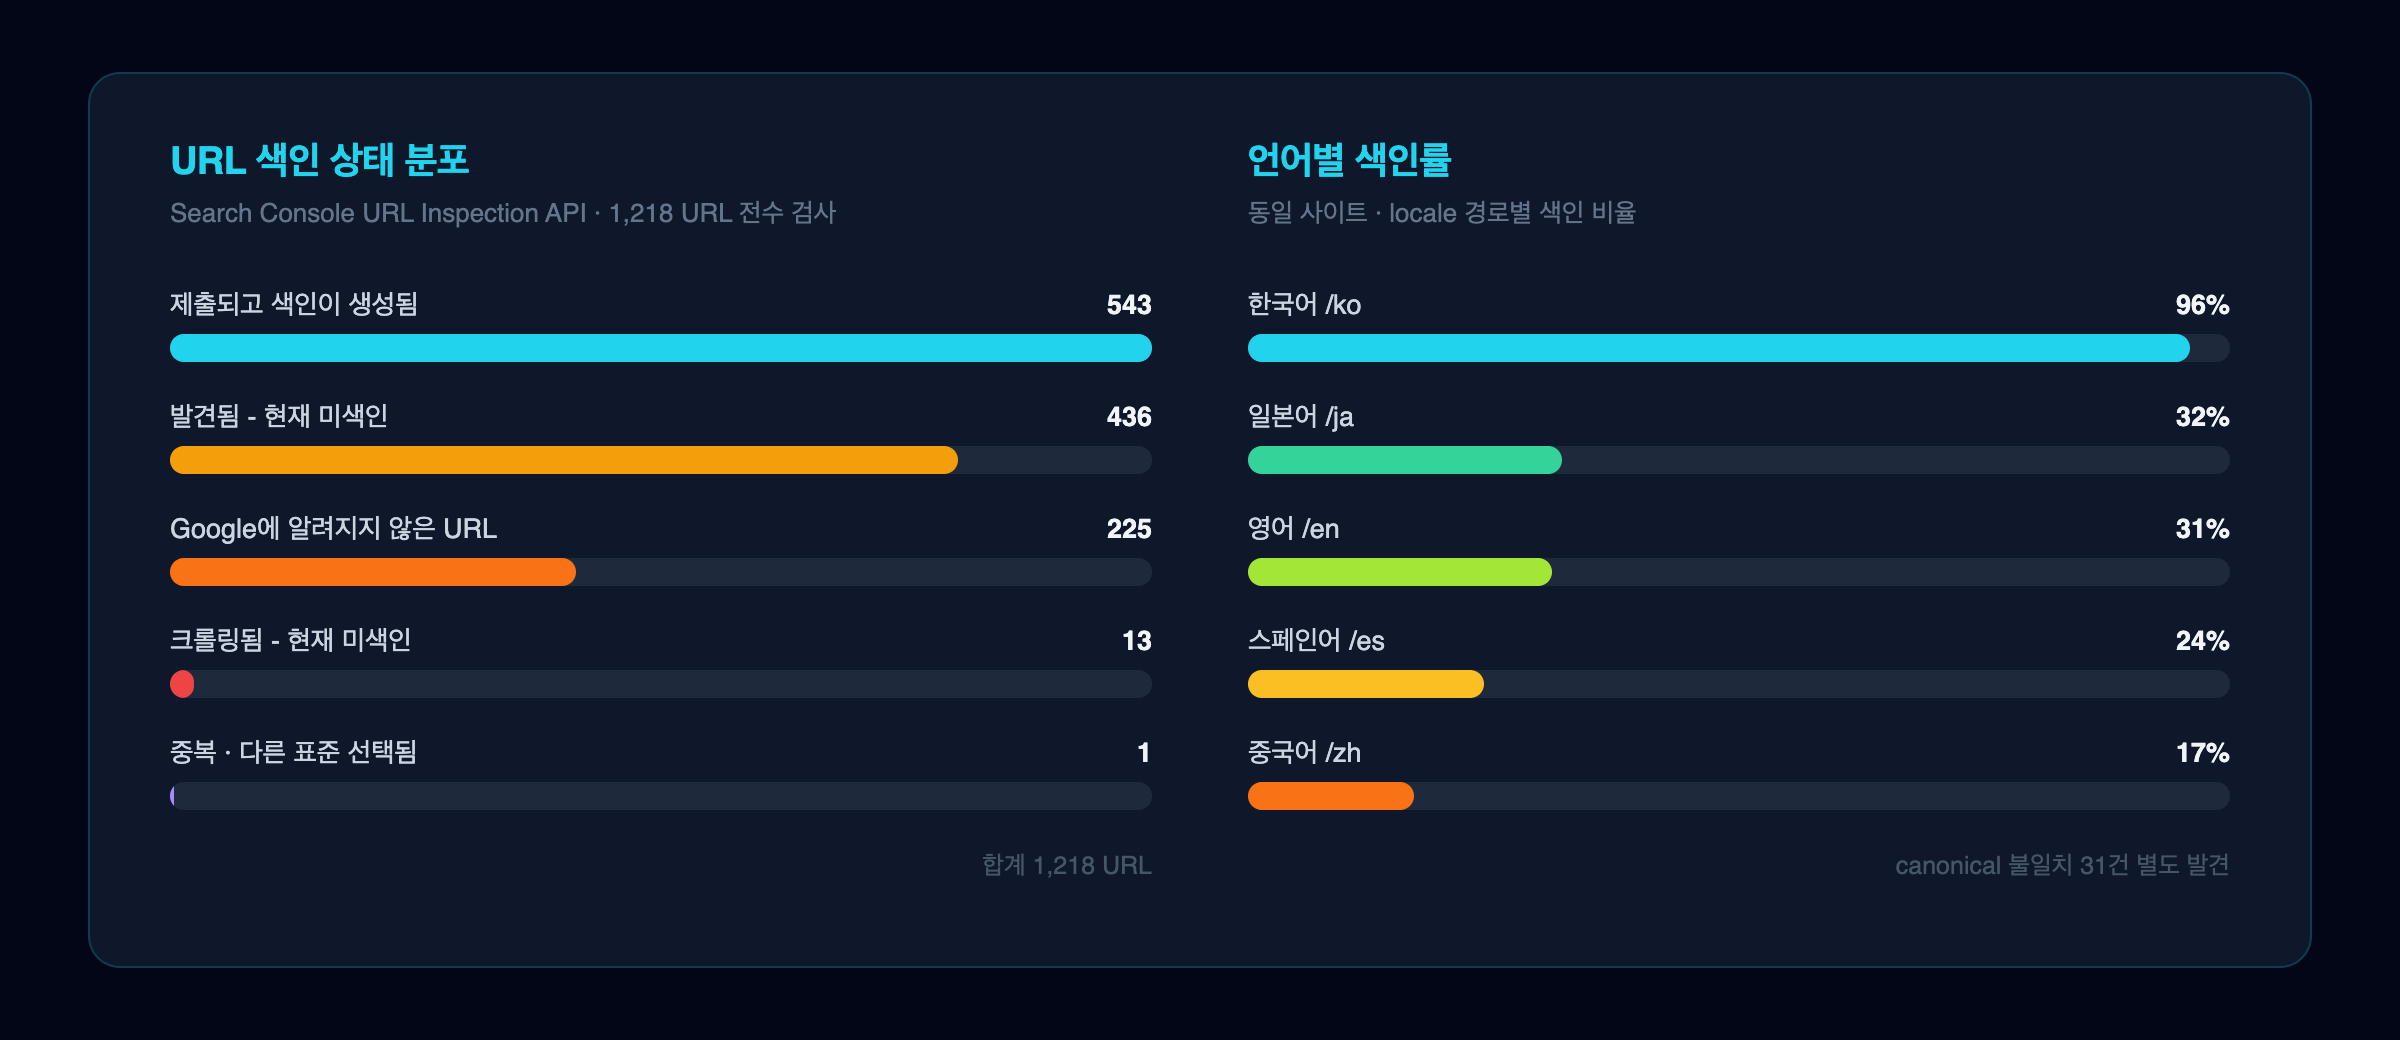
그리고 무려 31개 페이지에서 canonical 불일치가 발견됐습니다. 파고 들어가 보니 일본어 페이지들이 "나는 영어 페이지가 표준이다"라고 잘못 선언하고 있던 버그였어요. 구글은 그 선언을 무시하고 자체적으로 표준을 골랐고 그 과정에서 색인이 꼬인 겁니다. 이런 건 웹 화면에서 하나씩 눌러봐선 절대 못 찾습니다. 1,200번은 못 누르니까요.
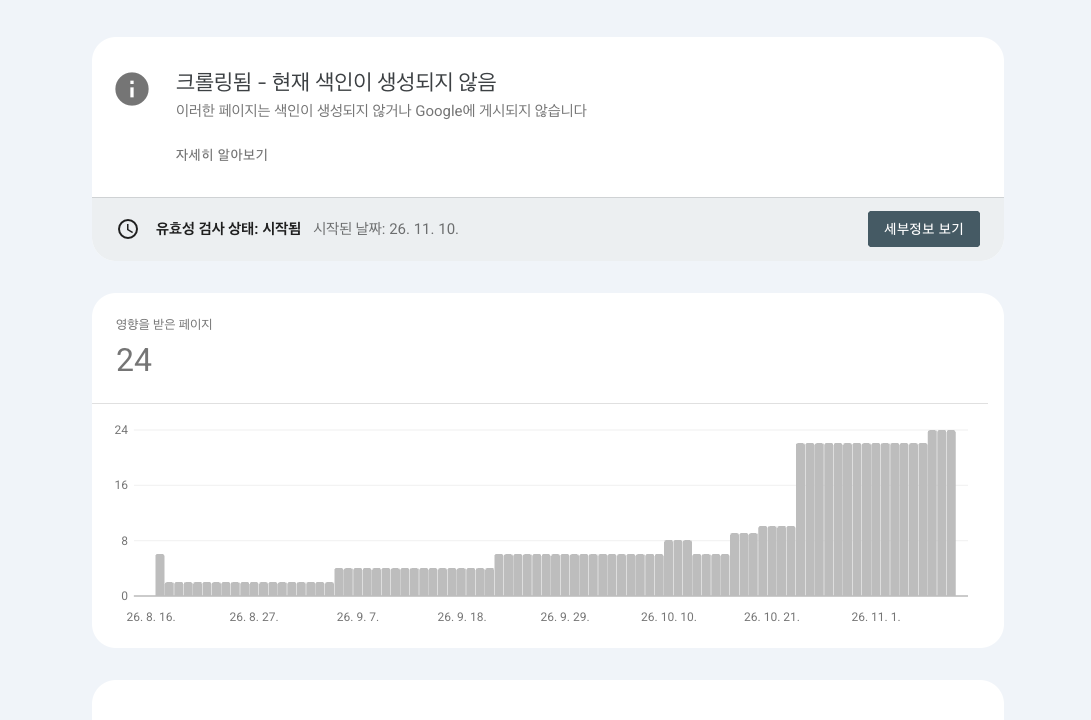
지금은 canonical 버그를 고쳐서 배포했고 서치콘솔에 유효성 검사를 걸어둔 상태입니다. 며칠 뒤 API를 다시 돌려서 coverageState가 어떻게 바뀌는지 추적할 예정이에요.
코드는 의외로 단순합니다
핵심은 POST 요청 하나입니다.
POST https://searchconsole.googleapis.com/v1/urlInspection/index:inspect
{
  "inspectionUrl": "검사할 URL",
  "siteUrl": "sc-domain:도메인 또는 등록된 속성 URL",
  "languageCode": "ko-KR"
}
여기에 서비스 계정 OAuth 토큰(webmasters.readonly 스코프)만 붙이면 끝입니다. 나머지는 sitemap 파싱과 결과 저장, 할당량 제한 로직이라 전체 200줄 남짓이에요.
정리
- 서치콘솔 URL 검사는 API로 대량 실행 가능합니다. 하루 약 2,000건
- 웹에서 하나씩 보는 것과 동일한 데이터를 받는데, 목록으로 뽑아 비교할 수 있다는 게 압도적 장점입니다
- canonical 불일치 같은 숨은 버그를 찾을 때 특히 강력합니다
- 준비는 Cloud에서 API 사용 설정 → 서비스 계정 발급 → 서치콘솔에 사용자 추가. 이게 전부예요
"검색에 왜 안 뜨지?" 하고 답답하셨던 분들은 한번 돌려보세요. 색인이 안 된 이유가 데이터로 딱 나오니까, 막연했던 문제가 할 일 목록으로 바뀝니다.
'유용한정보 > 블로그팁' 카테고리의 다른 글
| canonical이 뭔데 내 페이지 색인을 날렸을까 — 개념과 실제 버그 사례 (0) | 2026.11.14 |
|---|---|
| 네이버 서치어드바이저는 API가 없습니다, 그래서 직접 자동화했어요 (1) | 2026.11.14 |
| 내 웹사이트를 네이버에서 검색 등록 방법 - 2 (RSS,사이트맵,신디케이션핑, 채널) (0) | 2018.07.27 |
| 내 웹사이트를 네이버웹마스터도구에 등록하는 방법 - 1 (0) | 2018.07.27 |
| 네이버 상위 노출 웹마스터도구 상위 1% 도달하기 (0) | 2018.07.22 |


